Т-клетки — патрульная служба иммунной системы. Каждая несет на поверхности уникальный рецептор и обходит организм в поисках единственной подходящей ему молекулярной мишени: фрагмента вирусного белка, опухолевого антигена или, при аутоиммунном заболевании, собственной молекулы тела. Узнав свою мишень, клетка запускает иммунный ответ.
Составить картотеку этих соответствий — одна из главных задач современной иммунологии. Зная, какой рецептор узнает конкретный антиген, можно отследить ответ на инфекцию или вакцину, найти и размножить нужные клетки для терапии опухоли, подобрать мишень для противораковой вакцины. За последние годы такие пары собрали в базы данных, где счет идет на сотни тысяч записей; одну из крупнейших, VDJdb, разрабатывают авторы работы.
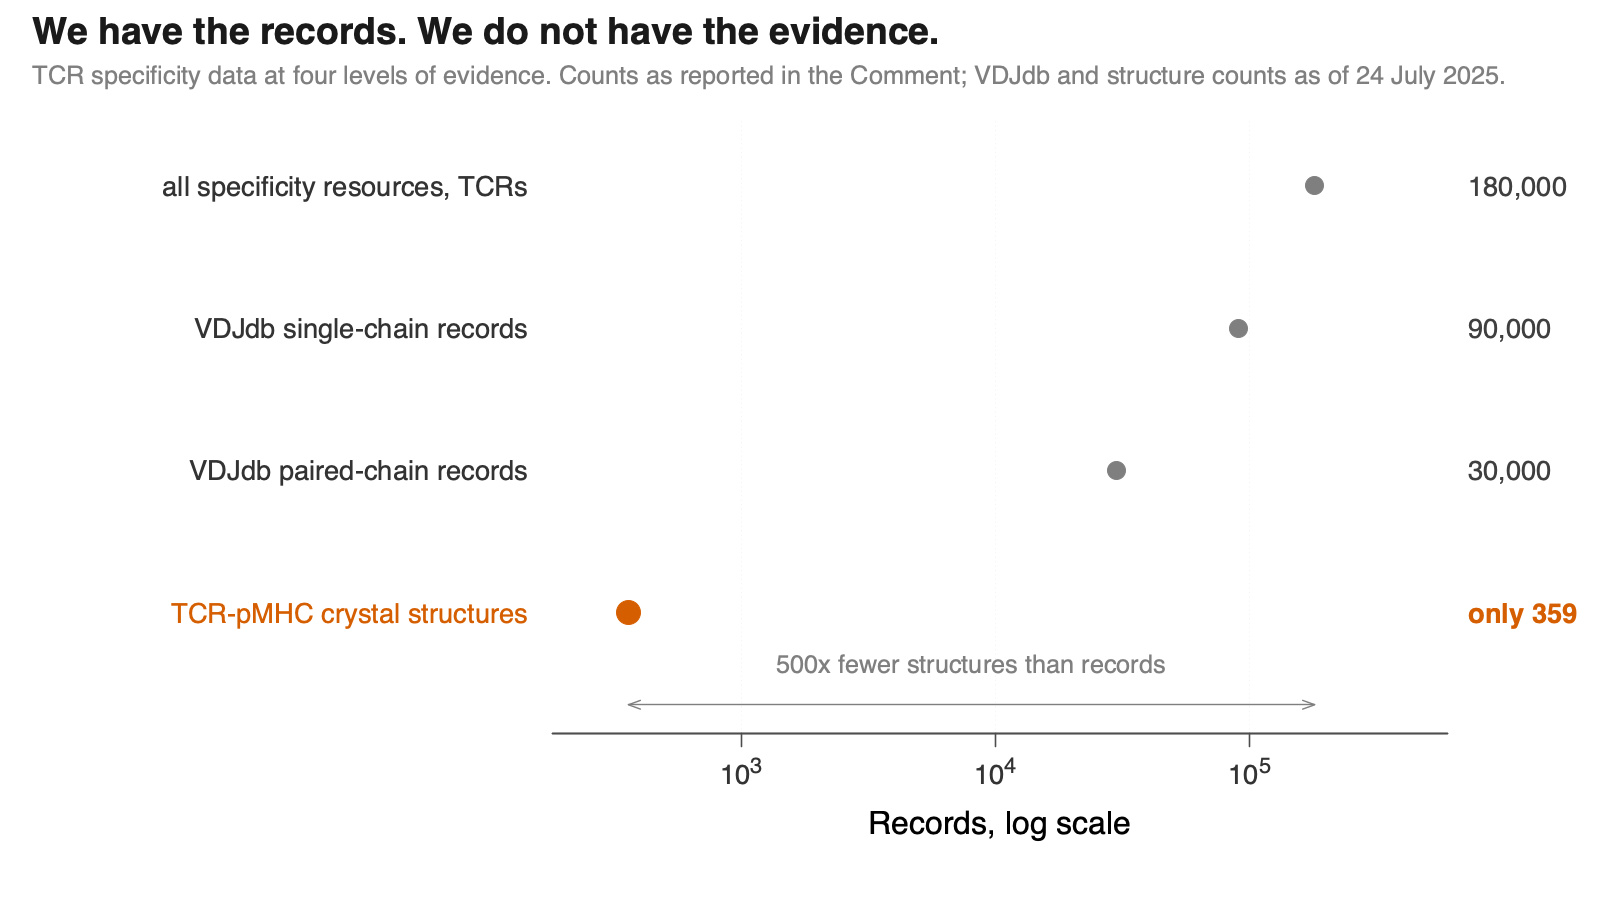
Данные о специфичности Т-клеточных рецепторов на четырех уровнях доказательности: около 180 000 рецепторов во всех ресурсах против 359 расшифрованных трехмерных структур комплексов (на 24 июля 2025 года). Логарифмическая шкала. Источник: ИБХ РАН
Но у этой картотеки есть уязвимое место. Абсолютно надежное доказательство — расшифрованная трехмерная структура комплекса рецептора с мишенью — существует лишь для нескольких сотен пар, примерно в пятьсот раз реже, чем записи в базах. Сверить каждую запись с эталоном невозможно: доверие приходится оценивать статистически.
Ошибки в базах появляются не от небрежности, а из арифметики самого эксперимента. Чтобы найти клетки, узнающие нужную мишень, их вылавливают из крови приборами клеточной сортировки. Метод хороший, но не идеальный: вместе с нужными клетками в пробирку неизбежно попадает небольшая примесь посторонних — обычно от половины до одного процента.
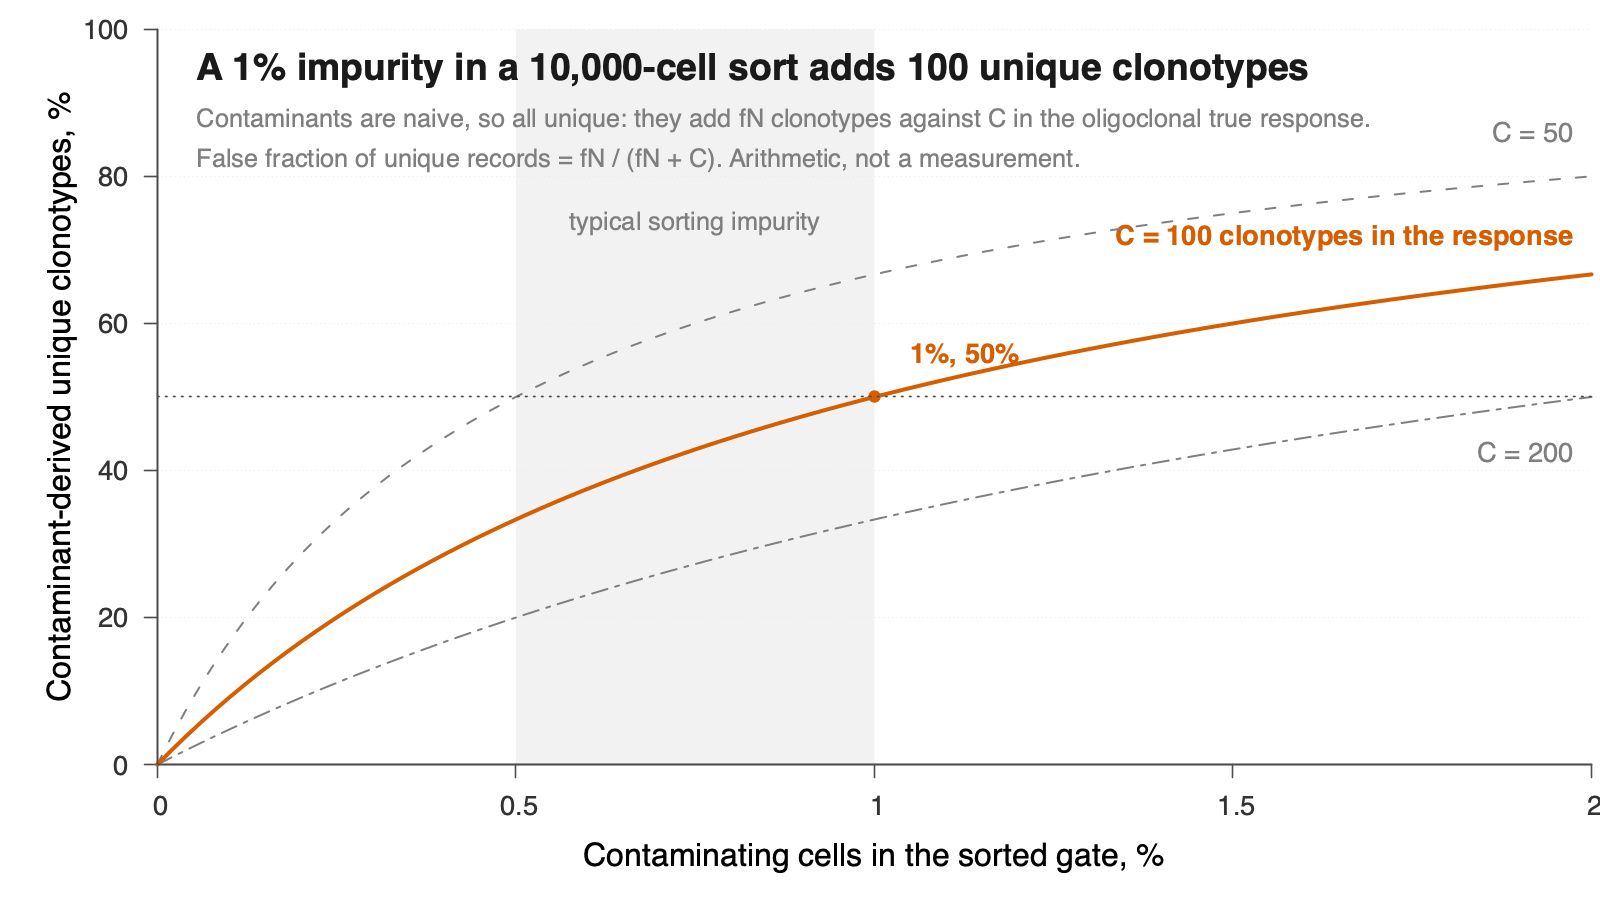
Доля ложных уникальных вариантов растет с примесью в отсортированной фракции. Серая полоса — обычный для клеточной сортировки уровень примеси. Ложные записи возникают закономерно, а значит, поддаются статистическому учету. Источник: ИБХ РАН
Дальше срабатывает статистическая ловушка. Настоящий иммунный ответ узкий: на одну мишень отвечает ограниченный набор клеточных клонов, и одни и те же рецепторы встречаются в пробе многократно. Посторонние же клетки берутся из общего пула, где почти каждая несет свой неповторимый рецептор. В результате горстка случайных клеток порождает в разы больше разных вариантов, чем весь истинный ответ, — и до половины уникальных записей может оказаться ложными.
Именно такую картину и показал недавний масштабный скрининг, в котором записи из базы данных перепроверяли на роботизированной платформе.
Напрашивается простое решение: доверять тем записям, которые независимо встретились сразу в нескольких работах. Авторы показали, что это не работает.
Часть рецепторов — «публичные»: они устроены так, что организм собирает их особенно легко, и потому они есть почти у каждого человека. Такой рецептор будет всплывать в работе за работой независимо от того, узнает он заявленную мишень или нет. Повторяемость здесь говорит не о надежности результата, а об устройстве генома.
Есть и более показательный сигнал тревоги. Если верить базам, отдельные рецепторы узнают по десятку разных мишеней сразу. Такая всеядность биологически почти невозможна: клетка с настолько неразборчивым рецептором не прошла бы отбор в тимусе, где Т-клетки учатся не реагировать на тысячи собственных белков организма. Значит, перед нами не феномен, а артефакт.
Вывод авторов: задачу нужно ставить иначе. Не считать подтверждения, а отфильтровывать шум.
Настоящий иммунный ответ оставляет узнаваемый почерк. Рецепторы разных людей, узнающие одну и ту же мишень, похожи друг на друга — эволюция раз за разом приходит к сходному решению. Такое семейство похожих рецепторов образует мотив, своего рода фоторобот ответа на конкретный антиген.
Трудность в том, что похожие рецепторы возникают и сами по себе, без всякого отбора: механизм их сборки устроен так, что одни варианты получаются часто, а другие почти никогда. Принять это фоновое сходство за признак общей специфичности очень легко.
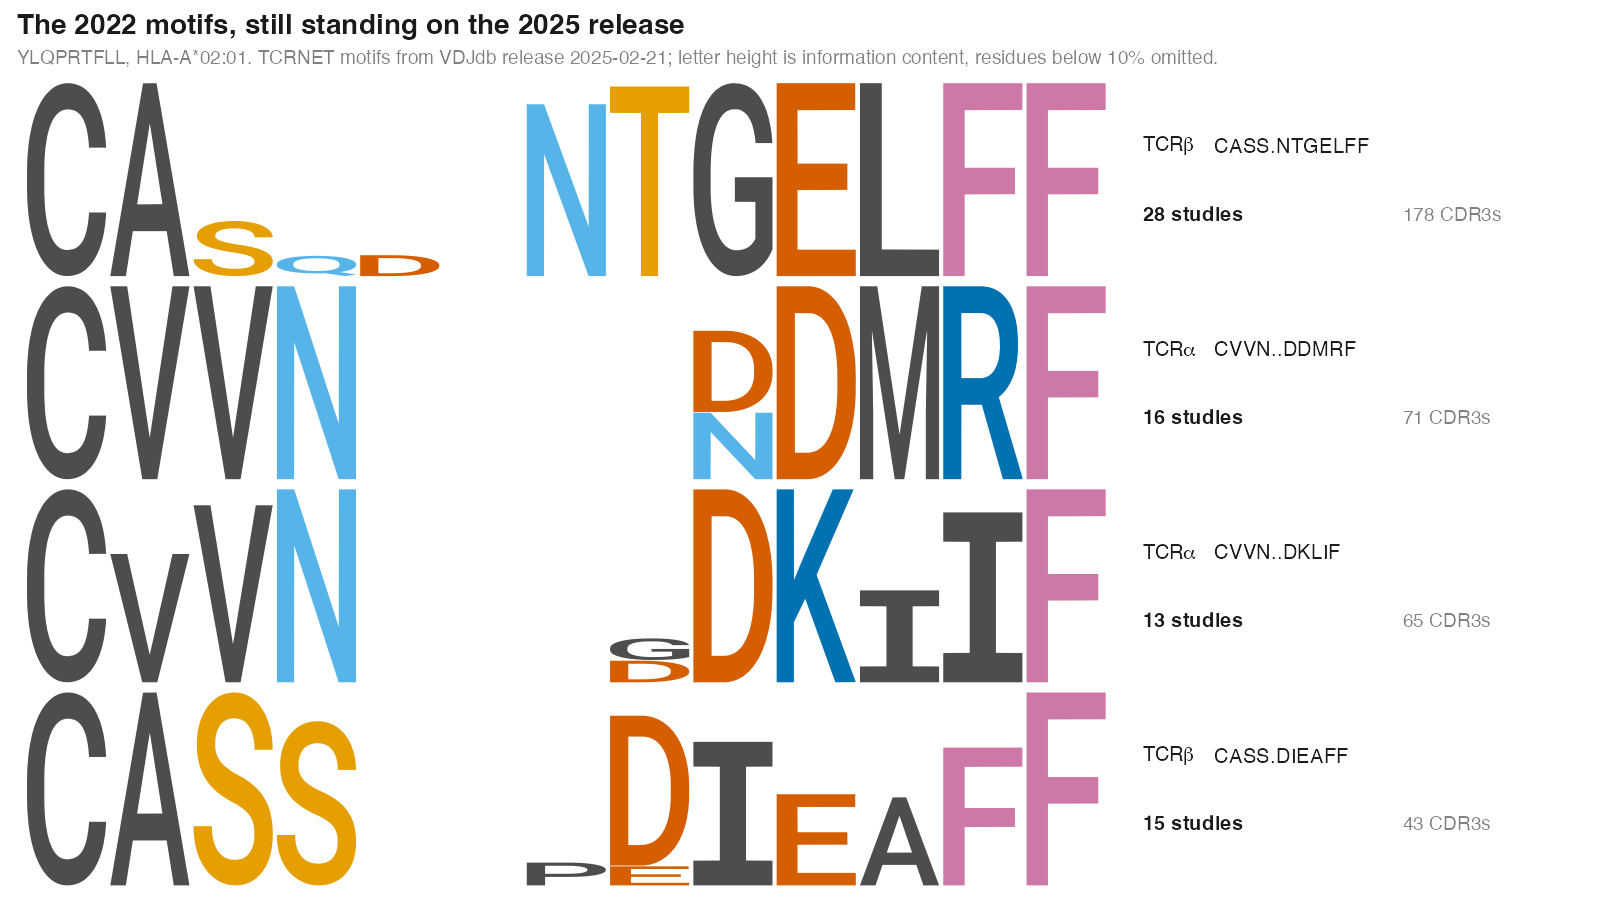
Четыре мотива TCRNET для эпитопа YLQPRTFLL коронавируса SARS-CoV-2 по данным VDJdb на февраль 2025 года. Высота буквы отражает, насколько строго закреплена позиция. Справа для каждого мотива — цепь рецептора, консенсус, число независимых исследований и число последовательностей. Источник: ИБХ РАН
Метод TCRNET, предложенный авторами еще в 2019 году, вычитает этот фон и оставляет только те семейства, которые случайностью не объясняются. В новой работе ему впервые отведена роль обязательного фильтра для всей базы данных — шага, который следует выполнять до того, как на этих данных начнут учить предсказательные модели.
Убедительнее всего то, что почерк не выцветает со временем. Четыре мотива для одной из мишеней коронавируса, описанные авторами в 2022 году, продолжают собираться из данных независимых лабораторий и три года спустя. Самый крупный из них сложился из работ 28 научных групп.
Проверить фильтр удалось благодаря независимому эксперименту: коллеги авторов перепроверили на роботизированной платформе около 1 700 записей для двух вирусных мишеней, ничего не зная о результатах компьютерного анализа.
Совпадение оказалось убедительным. Записи, попавшие в мотивы, подтвердились в эксперименте в 81% случаев, не попавшие — в 38%. Шансы на независимое подтверждение у отфильтрованных записей выше в семь раз.
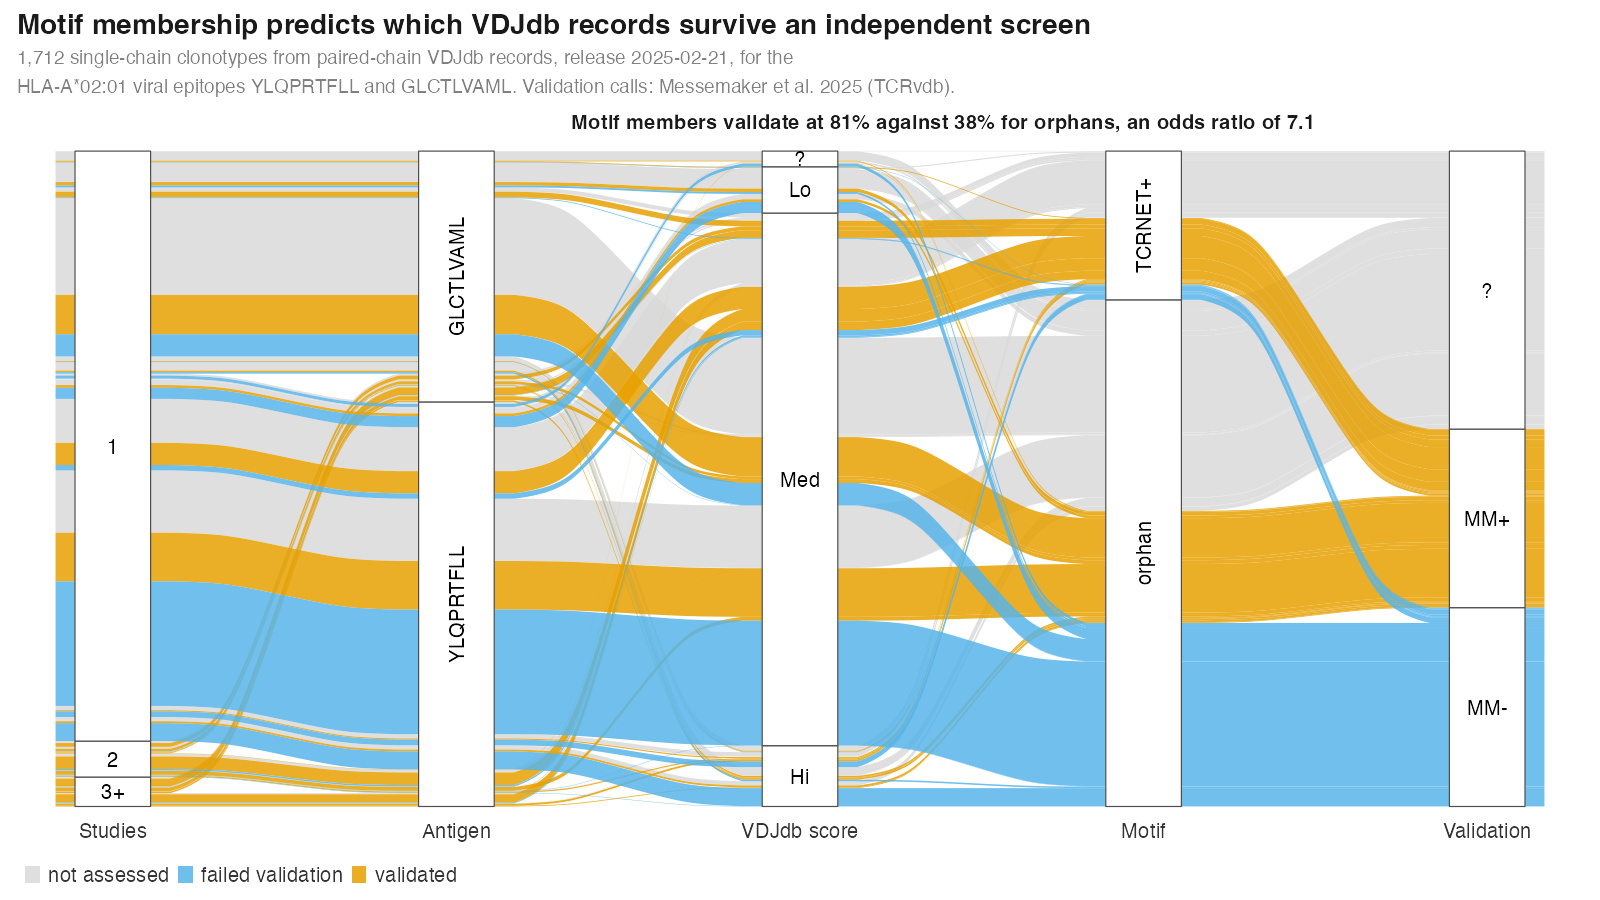
Судьба записей базы данных: от числа исследований и антигена до оценки достоверности, принадлежности к мотиву и исхода независимой проверки. Оранжевым показаны подтвержденные записи, голубым — не подтвердившиеся, серым — не проверявшиеся. Источник: ИБХ РАН
Два совершенно разных подхода — статистика последовательностей на компьютере и живые клетки в лаборатории — сошлись на одном и том же наборе записей. Для поля, где надежного эталона почти нет, это сильнейший из доступных аргументов.
Здесь начинается главное отличие новой работы от простой констатации проблемы. Выяснилось, что картотека иммунитета вовсе не наполовину испорчена.
Во-первых, бóльшая часть подтвержденных записей лежит за пределами мотивов. Фильтр выделяет ядро повышенной надежности, но не обесценивает остальное: там остается множество подлинных рецепторов, в том числе редкие высокоаффинные варианты, которые по определению не образуют семейств. Поэтому фильтровать следует ради точности, когда цена ошибки высока, а не ради того, чтобы сократить базу.
Во-вторых, значительная доля «неудачных» проверок — до трети — объясняется вовсе не тем, что рецептор не узнает мишень. Т-клеточный рецептор состоит из двух цепей, и в данных они нередко оказываются соединены неверно; сходным образом сбивает результат неточное определение генов, из которых рецептор собран. Это ошибки разметки, а не биологии, и они исправимы — нужны дополнительная проверка спаривания цепей и аккуратное оформление данных по принятым в поле стандартам.
В-третьих, у фильтрации обнаружился побочный выигрыш. Базы сильно перекошены: почти половина всех записей приходится на один распространенный вариант тканевой совместимости, просто потому что его удобнее всего изучать. Такой перекос мешает моделям машинного обучения работать со всем остальным разнообразием. Сборка записей в мотивы убирает избыточность и выравнивает перекос более чем вдвое, оставляя компактный и сбалансированный набор данных, на котором уже можно учить модели.
Есть и независимый способ проверить запись. Модели, предсказывающие трехмерную структуру белков, умеют собирать комплекс рецептора с мишенью и сообщать, насколько они уверены в получившейся конструкции.
Оказалось, что одной этой уверенности достаточно, чтобы отличить настоящие пары от ложных, — даже если модель вообще никогда не обучали на том, какие рецепторы связываются, а какие нет. Она просто «видит», что у ложных пар комплекс не складывается.
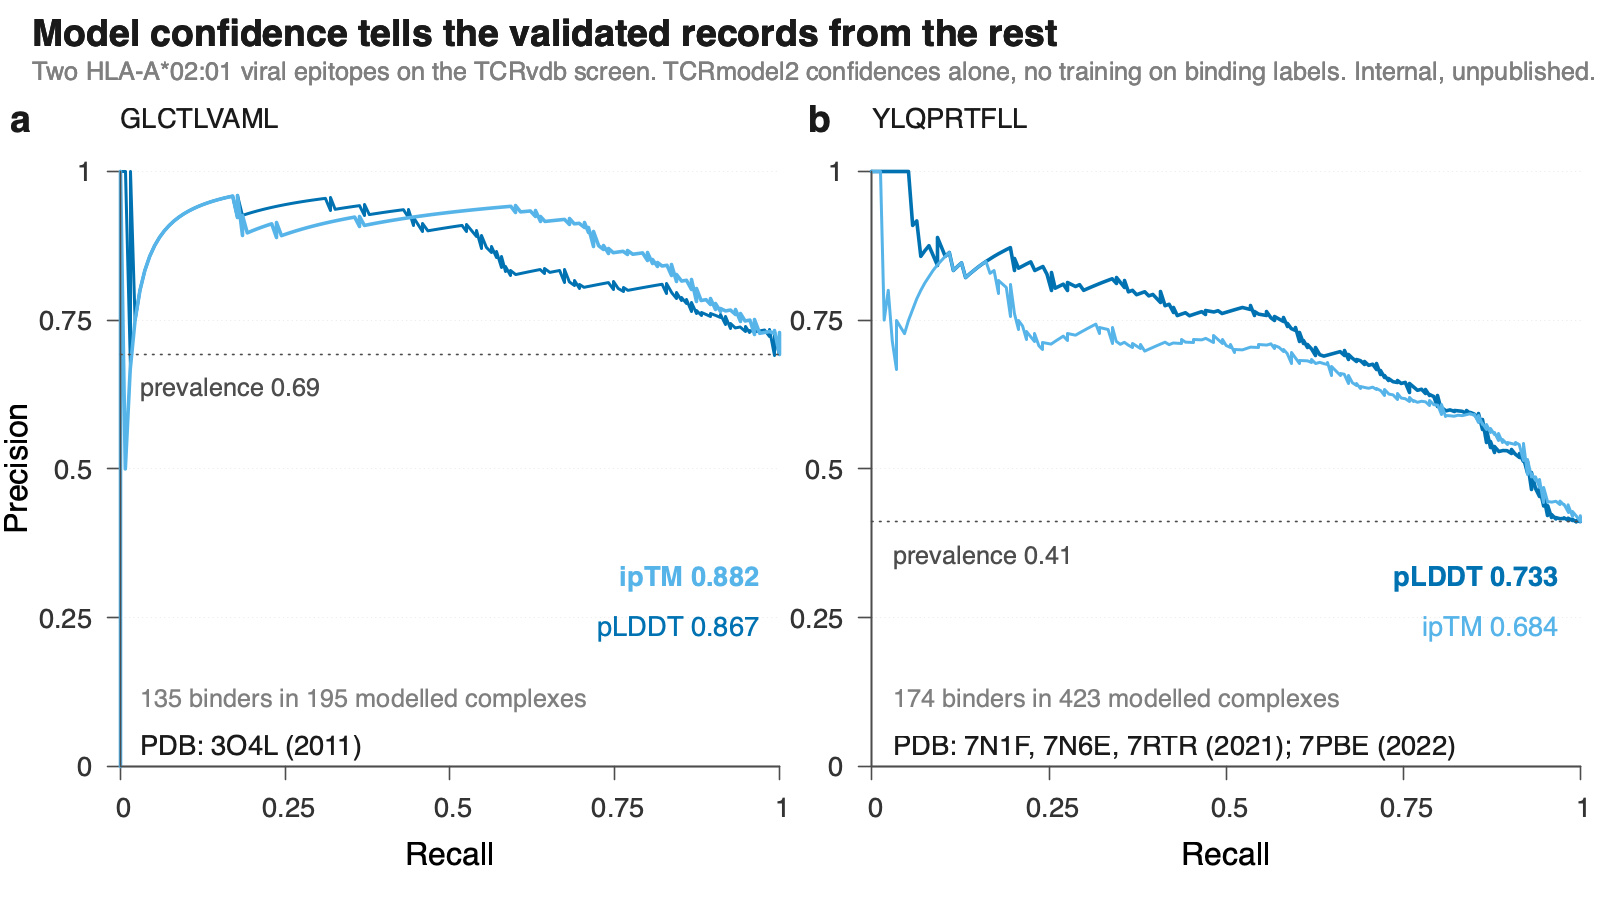
Уверенность структурной модели отделяет связывающие рецепторы от несвязывающих на двух вирусных мишенях. Пунктир — уровень, который дало бы случайное угадывание. Неопубликованные данные авторов. Источник: ИБХ РАН
Ценность такого фильтра в его независимости: он опирается на трехмерную структуру, а не на статистику последовательностей, и потому ошибается иначе. Два независимых фильтра, срабатывающих на одной записи, дают гораздо больше уверенности, чем один. Тот же принцип уже работает в чужих руках: алгоритм коллег-соавторов по скринингу успешно предсказывает, какие записи пройдут лабораторную проверку.
Нужда в таких фильтрах ощущается остро. В открытых соревнованиях по предсказанию специфичности точность лучших моделей уже несколько лет не поднимается заметно выше 60%, и авторы связывают это прежде всего с качеством входных данных: мусор на входе — мусор на выходе.
Собранные вместе, эти элементы складываются в рабочий цикл, который авторы называют lab-in-the-loop — «лаборатория в контуре». Статистический фильтр и структурная модель отбирают наиболее правдоподобные записи, робот проверяет их на живых клетках, результат возвращается в модель и в базу данных. Следующий круг начинается с более чистых данных и более точной модели. В отличие от разовой проверки, такой цикл позволяет улучшать всю картотеку постепенно и безостановочно — и годится не только для описанных ранее рецепторов, но и для сконструированных на компьютере.
Особую ценность в этой схеме приобретают отрицательные результаты. Сегодня моделям остро не хватает достоверных примеров того, что не связывается, и их заменяют искусственно придуманными — в итоге модель учится распознавать выдумку, а не биологию. Роботизированная проверка выдает настоящие отрицательные результаты как побочный продукт, и эти данные бесценны как для обучения, так и для честной оценки моделей.
Главный посыл работы — вернуть в поле норму независимого подтверждения. Ни статистический фильтр, ни искусственный интеллект не выносят окончательного вердикта: они лишь резко повышают шансы и экономят усилия, указывая, что проверять в первую очередь. Последнее слово остается за экспериментом. Авторы показывают, что теперь это сочетание реально выстроить — и что данные, на которых строится будущая иммунотерапия, могут быть куда надежнее, чем сегодня.